Index bloat là tình trạng website có quá nhiều URL giá trị thấp hoặc trùng lặp được index, khiến crawl budget bị loãng và các trang quan trọng khó nổi bật hơn. Nói ngắn gọn, đây là lúc công cụ tìm kiếm đang lưu quá nhiều “nhiễu” trong chỉ mục của bạn, thay vì ưu tiên những trang thật sự mang lại giá trị cho người dùng và doanh thu.
- Index bloat thường đến từ tag, category, author archive, search page, tham số lọc và các URL mỏng.
- Dấu hiệu rõ nhất là số URL index tăng nhanh nhưng traffic, CTR và chuyển đổi không tăng tương ứng.
- Giải pháp đúng thứ tự là audit indexability, áp noindex/canonical hợp lý, rồi prune hoặc hợp nhất nội dung thừa.
- Robots.txt chỉ nên dùng để chặn crawl trap hoặc phần URL không cần bot vào, không phải thuốc chữa mọi vấn đề index.
Nếu bạn đã đọc về indexability hoặc crawl budget, index bloat là bước đi xa hơn của cùng một vấn đề: website có quá nhiều đường dẫn được phép tồn tại trong index, nhưng không phải đường dẫn nào cũng đáng được ưu tiên. Khi chỉ mục phình to, bot phải chia thời gian cho các trang yếu, còn các trang chiến lược lại chậm được đánh giá hoặc bị “lẫn” trong một đống tín hiệu kém chất lượng.
Index bloat là gì?
Index bloat là hiện tượng một website sở hữu lượng lớn URL được lập chỉ mục dù nhiều URL trong số đó không có giá trị tìm kiếm, không có nhu cầu truy cập thực sự hoặc chỉ là bản sao mỏng của nội dung khác. Trong thực tế, chỉ mục phình to không phải lúc nào cũng là “nhiều hơn là tốt hơn”. Một website ấn tượng không phải website có số URL index lớn nhất, mà là website có tỷ lệ URL index hữu ích cao nhất.
Điểm nguy hiểm của index bloat nằm ở chỗ nó thường diễn ra âm thầm. Bạn có thể thấy bài viết chính vẫn sống, nhưng phía sau là hàng trăm URL archive, filter, search, pagination, author, tag hoặc tham số có thể được index. Nếu không có chiến lược phân loại rõ ràng, Google sẽ mất thời gian khám phá những trang này và làm loãng độ ưu tiên cho các trang nên được crawl thường xuyên hơn. Đây là lý do audit index cần đi cùng SEO audit và không thể chỉ nhìn ở mức “bài nào đang lên top”.
Vì sao index bloat thường xuất hiện?
Index bloat hiếm khi xuất hiện chỉ vì một lỗi duy nhất. Nó thường là hệ quả của cách website được xây dựng, cách CMS sinh URL và cách đội nội dung vận hành hằng ngày. Ví dụ, WordPress có thể tạo archive theo ngày, tác giả, tag, category, trang tìm kiếm nội bộ và trang phân trang; một lớp filter thương mại điện tử có thể sinh ra vô số URL theo thuộc tính sản phẩm; còn một site content lớn lại dễ sinh ra bài trùng intent, bài ngắn, bài cập nhật nửa vời và URL cũ không được dọn dẹp.
- Archive/tag/category được index dù không mang ý định tìm kiếm rõ ràng.
- Trang tìm kiếm nội bộ hoặc trang lọc biến thể bị bot crawl và index.
- URL tham số tạo ra nhiều bản sao gần giống nhau.
- Trang mỏng, trang cũ hoặc bài trùng chủ đề chưa được hợp nhất.
- Hệ thống internal link đẩy quá nhiều tín hiệu vào các URL phụ.
Khi nhìn nguyên nhân, bạn sẽ thấy index bloat không chỉ là bài toán kỹ thuật. Nó còn liên quan đến content planning, cấu trúc danh mục, chiến lược internal link và việc ai chịu trách nhiệm dọn dẹp nội dung cũ. Nếu đội content tạo liên tục nhưng không có quy trình loại bỏ bớt phần dư, index sẽ phình giống như một kho chứa mà không ai kiểm kê.
Dấu hiệu website đang bị index bloat
Dấu hiệu đầu tiên thường thấy là số lượng trang được Google index lớn hơn rất nhiều so với số trang có giá trị thực. Bạn có thể kiểm tra sơ bộ bằng lệnh site:, nhưng cách đó chỉ mang tính tham khảo. Dữ liệu đáng tin hơn đến từ Google Search Console, log server và số liệu chuyển đổi. Nếu site có vài trăm trang hữu ích nhưng lại index hàng nghìn URL mỏng, gần như chắc chắn đã có bloat.
Một dấu hiệu nữa là bạn thấy các URL vô nghĩa chiếm chỗ trong báo cáo coverage: trang search nội bộ, tag ít dùng, archive không cần thiết, filter URL, hoặc các trang pagination sâu. Những URL này có thể không kéo traffic, nhưng vẫn tạo tín hiệu tiêu hao crawl. Khi đó, bạn nên xem lại lớp meta robots noindex, canonical tag và robots.txt trước khi chặn bừa bằng các quy tắc kỹ thuật.
Crawl log cũng cho thấy câu chuyện tương tự: bot ghé nhiều vào các URL phụ nhưng lại ít quay lại các trang quan trọng như trang dịch vụ, bài pillar hoặc landing page có chuyển đổi. Nếu tổng traffic không tăng, nhưng số URL index và số lần bot request vẫn tăng, bạn nên coi đó là tín hiệu rõ của index bloat chứ không phải “Google đang quan tâm hơn”.
Index bloat làm SEO kém đi như thế nào?
Tác hại lớn nhất là crawl budget bị chia nhỏ. Khi bot phải xử lý quá nhiều URL yếu, thời gian dành cho các trang quan trọng giảm xuống. Điều này đặc biệt rõ ở site lớn, site thương mại điện tử hoặc site có nhiều nội dung cập nhật thường xuyên. Về lâu dài, những trang cần được crawl lại sớm có thể bị chậm cập nhật, còn những trang phụ lại vô tình được thu thập quá kỹ.
Hậu quả thứ hai là tín hiệu nội bộ bị pha loãng. Internal link vốn là cách bạn “bầu chọn” cho các trang chiến lược. Nhưng khi site chứa quá nhiều URL phụ, sức mạnh liên kết bị dàn trải, anchor text trở nên kém tập trung và các trang chính khó nhận được đủ độ nổi bật. Nếu bạn chưa từng rà lại mạng lưới link, hãy xem thêm Internal Link Audit là gì để biết cách kiểm tra chất lượng dòng link.
Hậu quả thứ ba là người làm SEO khó đọc đúng dữ liệu. Một website phình index có thể tạo cảm giác “nhiều hoạt động”, nhưng traffic thực tế lại không tăng tương xứng. Khi đó, team dễ nhầm lẫn giữa số lượng index và chất lượng index, giữa crawl activity và SEO performance. Đó là lý do bạn nên nhìn đồng thời vào index coverage, CTR, conversion và tỷ lệ URL hữu ích thay vì chỉ nhìn số đếm thô.
Cách xử lý index bloat đúng thứ tự
Không nên bắt đầu bằng việc chặn bừa bãi. Cách đúng là audit trước, quyết định sau và triển khai theo từng lớp. Bạn cần biết URL nào nên giữ lại, URL nào nên noindex, URL nào nên canonical về bản chính, URL nào nên hợp nhất nội dung và URL nào nên xóa hẳn. Nếu xử lý theo cảm tính, bạn có thể vô tình chặn nhầm trang đang mang traffic hoặc xóa nhầm trang có giá trị SEO.
- Kiểm tra indexability. Xem những nhóm URL nào đang được phép index và URL nào đang không có lý do để tồn tại trong index.
- Áp noindex cho nhóm yếu. Các trang search nội bộ, tag rác, archive vô nghĩa hoặc trang lọc quá mỏng thường là ứng viên tốt cho noindex.
- Giữ canonical sạch. Nếu có nhiều biến thể gần giống nhau, canonical phải trỏ về bản chính thay vì để bot tự đoán.
- Chỉ dùng robots.txt đúng chỗ. Robots.txt hữu ích cho crawl trap hoặc URL không cần bot vào, nhưng không nên dùng để giải quyết mọi trường hợp index.
- Gộp hoặc xóa nội dung thừa. Với các bài trùng intent, hãy merge, redirect hoặc prune thay vì để cả hai cùng tranh nhau tín hiệu.
- Rà lại internal link và sitemap. Chỉ giữ các URL đáng index trong sitemap và trong dòng link nội bộ chính.
Ở bước xử lý nội dung, Content Pruning là công việc không thể thiếu. Nhiều đội SEO chỉ nghĩ pruning là xóa bài cũ, nhưng thực tế nó còn bao gồm hợp nhất, cập nhật, chuyển hướng và dọn lại cấu trúc cụm chủ đề. Nếu bạn làm tốt phần này, chỉ mục không chỉ gọn hơn mà còn “sạch ý định” hơn.
So sánh noindex, robots.txt, canonical và content pruning
| Giải pháp | Nên dùng khi nào | Ưu điểm | Lưu ý |
|---|---|---|---|
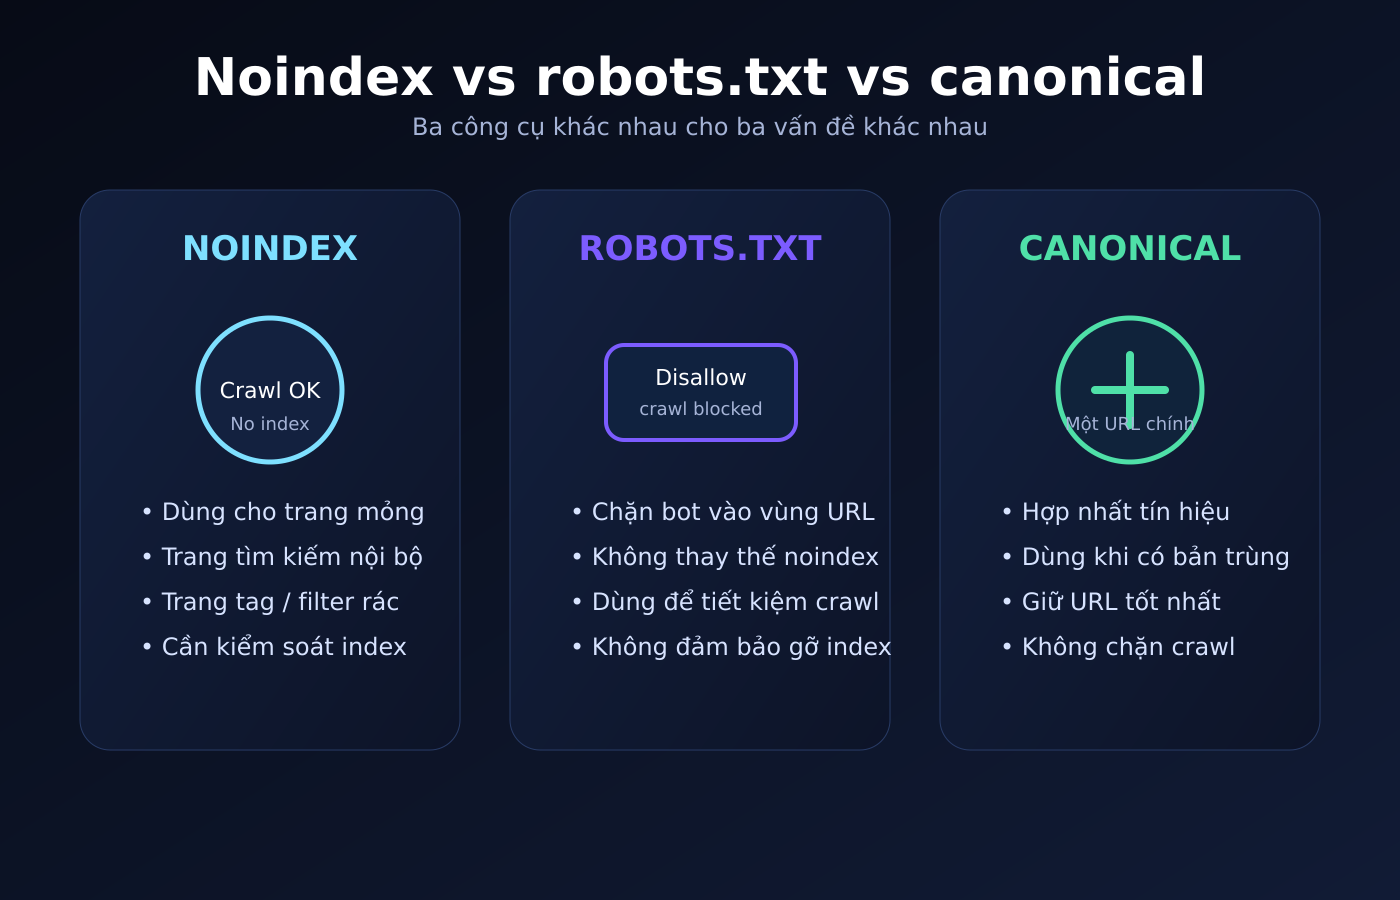
| Noindex | Trang vẫn cần crawl nhưng không nên xuất hiện trong index | Giữ bot có thể đọc tín hiệu nhưng chặn index | Chỉ hiệu quả khi trang vẫn được phép crawl |
| Robots.txt | Muốn tiết kiệm crawl hoặc chặn crawl trap | Ngăn bot vào một nhóm URL | Không phải lúc nào cũng xóa được URL khỏi index nếu URL đã được biết đến |
| Canonical | Có nhiều URL gần giống nhau, chỉ một bản chính | Hợp nhất tín hiệu về trang chuẩn | Phải nhất quán với nội dung và internal link |
| Content pruning | Trang mỏng, trùng intent hoặc không còn vai trò | Làm sạch kiến trúc nội dung từ gốc | Cần kiểm tra redirect và link nội bộ sau khi cắt |
Bảng trên quan trọng vì rất nhiều website dùng sai công cụ. Họ nghĩ robots.txt là cách xóa trang khỏi index, trong khi đúng hơn là noindex hoặc loại bỏ hẳn trang yếu. Họ nghĩ canonical có thể thay thế việc dọn nội dung, trong khi canonical chỉ là tín hiệu ưu tiên, không phải phép màu. Và họ nghĩ pruning là nhiệm vụ nguy hiểm, trong khi thực ra đó là bước phải làm nếu muốn cụm nội dung khỏe lên.
Quy trình 7 bước để xử lý trên WordPress
- Lập danh sách URL index. Xuất dữ liệu từ Search Console, sitemap và crawl tool để biết các nhóm URL đang tồn tại.
- Phân loại theo intent. URL nào phục vụ người dùng, URL nào chỉ là archive, filter, search hoặc bản sao mỏng.
- Chọn chính sách cho từng nhóm. Giữ, noindex, canonical, redirect hay xóa.
- Cập nhật taxonomy và archive. Rà lại tag, category, author archive và search page.
- Làm sạch internal link. Đừng trỏ link sang URL phụ nếu URL đó không cần index.
- Cập nhật sitemap. Chỉ đưa URL đáng index vào sitemap XML.
- Kiểm tra lại sau 2–4 tuần. Xem index coverage, crawl log và số trang thực sự tạo traffic.
Nếu website có cấu trúc cụm nội dung, quy trình trên nên đi cùng Topic Cluster và Content gap analysis. Như vậy bạn vừa dọn bớt trang thừa, vừa biết cần bổ sung trang nào để tăng authority cho chủ đề chính. Trong nhiều trường hợp, đây là cách xử lý thông minh hơn nhiều so với việc cố giữ tất cả mọi URL đang tồn tại.
Checklist kiểm tra sau khi dọn index bloat
- Sitemap chỉ còn các URL thực sự hữu ích và có trạng thái 200.
- Trang search nội bộ, tag rác và archive kém giá trị đã được noindex hoặc loại bỏ.
- Canonical của các trang tương tự trỏ về bản chính.
- Internal link không còn đẩy mạnh các URL phụ vô nghĩa.
- Search Console cho thấy số URL index bắt đầu ổn định hoặc giảm đúng mục tiêu.
- Không có trang quan trọng nào bị noindex nhầm hoặc mất khỏi sitemap.
- Tỷ lệ URL tạo traffic tăng lên sau khi dọn bớt URL rác.
Lỗi thường gặp khi xử lý index bloat
Lỗi lớn nhất là xóa quá tay. Khi audit chưa đủ sâu, nhiều người gắn noindex hoặc chặn robots cho cả nhóm URL đang tạo traffic. Lỗi thứ hai là đổi canonical nhưng lại để internal link, sitemap và breadcrumb trỏ đến URL phụ. Khi các tín hiệu mâu thuẫn nhau, bot sẽ khó hiểu đâu là trang chính. Lỗi thứ ba là quên đo lại sau khi dọn, khiến bạn không biết đâu là thay đổi thật và đâu là biến động ngắn hạn.
Một sai lầm nữa là chỉ nhìn vào số URL index mà không nhìn vào chất lượng index. Ít URL index chưa chắc tốt nếu đó toàn là trang yếu; nhiều URL index chưa chắc xấu nếu mọi URL đều có vai trò rõ ràng. Mục tiêu đúng là tỷ lệ index hữu ích cao hơn, không phải chỉ số index thấp nhất có thể.
FAQ về index bloat
Index bloat có phải luôn xấu không?
Không. Chỉ xấu khi website index quá nhiều URL kém giá trị, trùng lặp hoặc không phục vụ intent tìm kiếm. Nếu website có nhiều URL hữu ích, số lượng index lớn vẫn có thể là bình thường.
Noindex và robots.txt khác nhau thế nào?
Noindex nói với công cụ tìm kiếm rằng trang có thể crawl nhưng không nên xuất hiện trong index; robots.txt chủ yếu dùng để chặn bot truy cập crawl một nhóm URL. Hai thứ này không thay thế hoàn toàn cho nhau.
Content pruning có làm mất traffic không?
Nếu làm đúng, pruning giúp giữ lại phần giá trị và loại bỏ phần nhiễu. Traffic có thể dao động ngắn hạn, nhưng về dài hạn thường tốt hơn vì cấu trúc nội dung gọn và rõ hơn.
Index bloat có liên quan tới crawl budget không?
Có. Khi chỉ mục phình to, bot phải tiêu tốn thêm tài nguyên cho URL ít giá trị, khiến crawl budget bị phân tán và các trang quan trọng có thể được crawl chậm hơn.
Cần một buổi SEO Audit để chặn index bloat ngay từ gốc?
AT Việt Nam có thể rà sitemap, index coverage, canonical, noindex, internal link và nội dung trùng để xác định nhóm URL nào nên giữ, nhóm nào nên cắt và nhóm nào nên hợp nhất.